别让Agent瞎想乱搜还闯祸:哪些能力该内化进模型,哪些必须交给Harness,这篇讲透
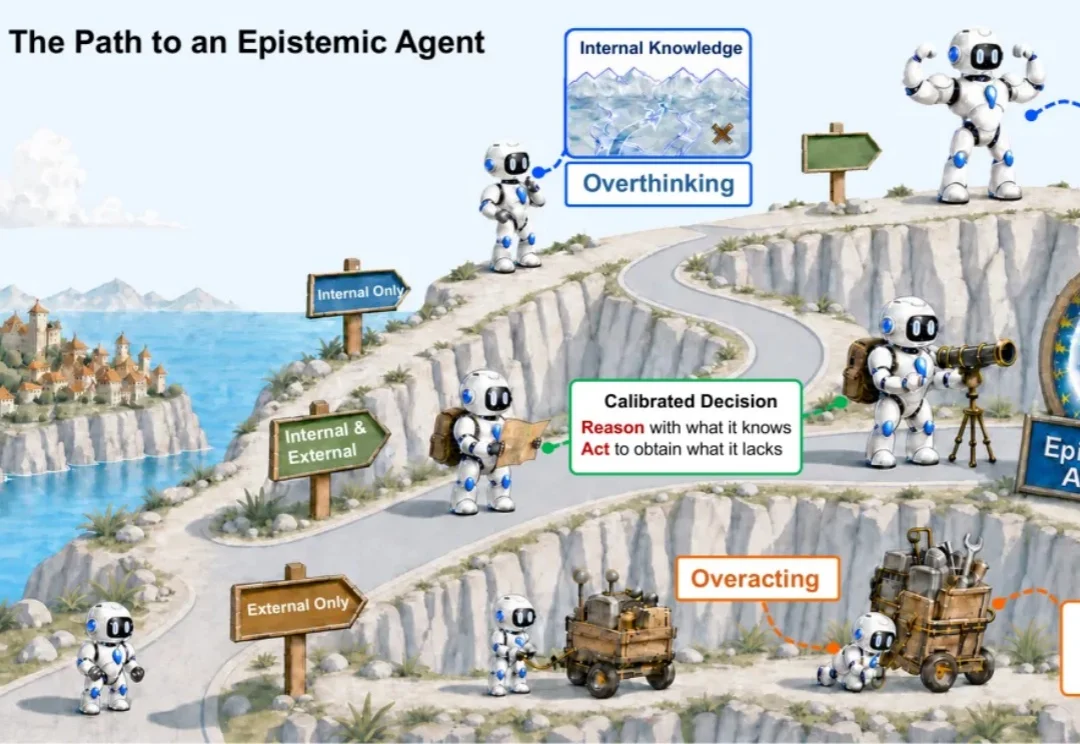
别让Agent瞎想乱搜还闯祸:哪些能力该内化进模型,哪些必须交给Harness,这篇讲透北航、南方科技大学、复旦大学、北京理工大学、爱丁堡大学等 8 家机构的 19 位研究者联合完成 Theory of Agent 综述,讨论模型内部与外部 harness 应如何分配能力,并据此梳理 LLM Agent 的学习、对齐、演化与评测。
搜索
北航、南方科技大学、复旦大学、北京理工大学、爱丁堡大学等 8 家机构的 19 位研究者联合完成 Theory of Agent 综述,讨论模型内部与外部 harness 应如何分配能力,并据此梳理 LLM Agent 的学习、对齐、演化与评测。
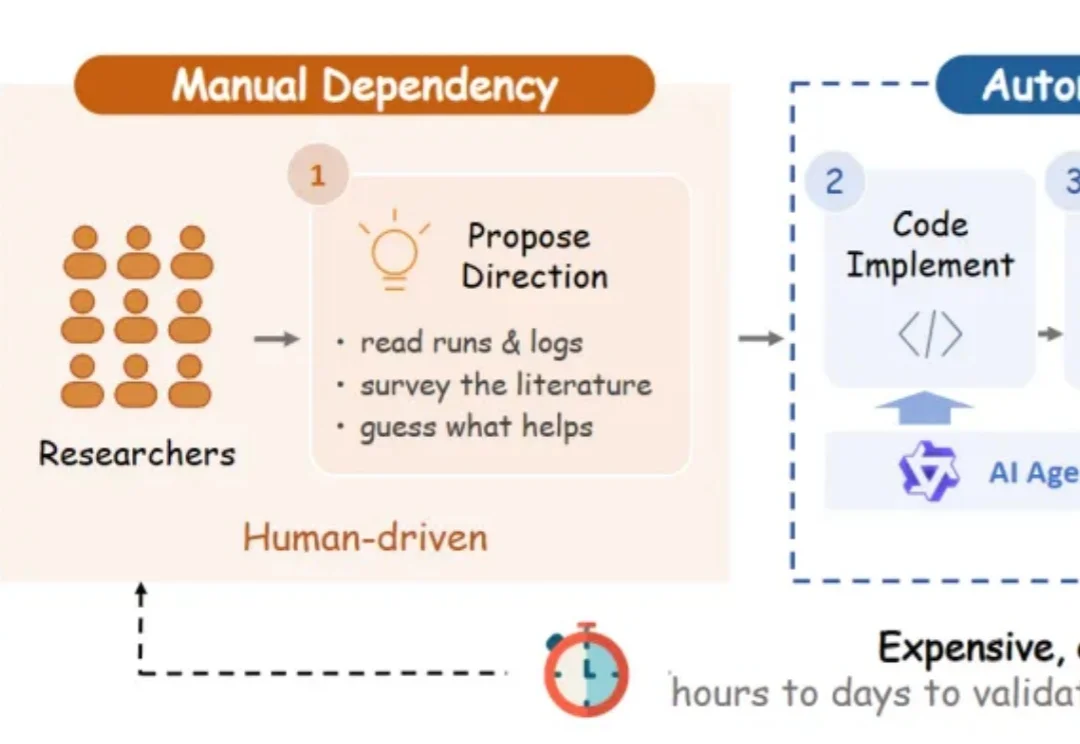
如今的 AI 已经能顺畅地帮你写代码、跑实验、做评估。算法工程师的每一天,几乎变成了:让 LLM 整理昨天的实验结果,让 LLM 实现新想法,让 LLM 监控实验运行…… 似乎只需把需求告诉 AI,它就能完成大部分算法工作。
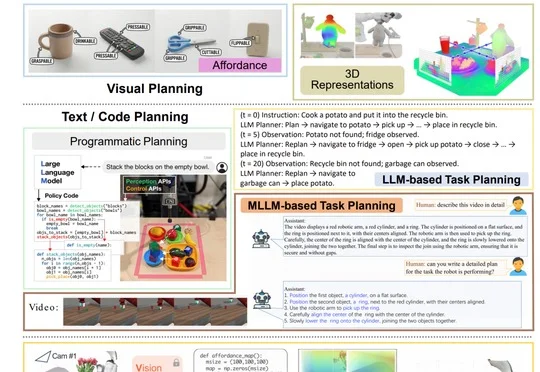
过去几年,机器人操作领域几乎被一批新概念重新 “刷屏”。 LLM Planner、VLA、Diffusion Policy、Flow Matching、Latent Action、World Mode
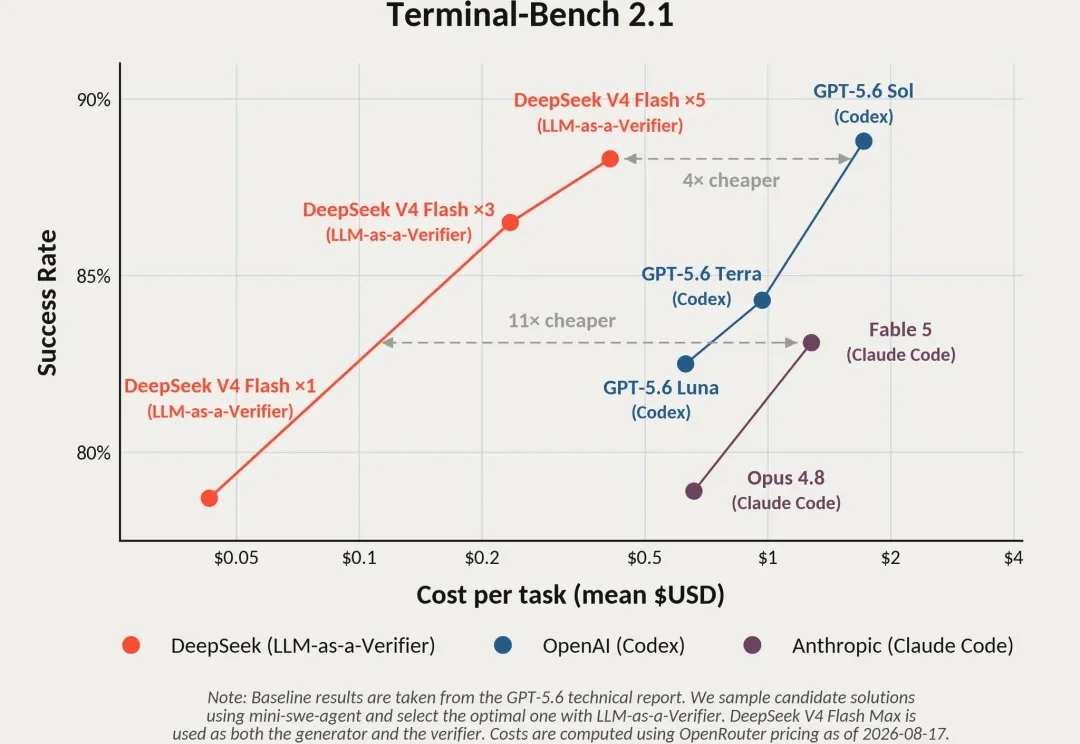
随着开源模型能力不断提升,它们已经能够以极低的成本生成多个高质量候选方案,并进一步利用模型自身对这些结果进行验证、打分和筛选。斯坦福团队最新实验发现,使用 DeepSeek V4 Flash + LLM-as-a-Verifier 进行「自验证」,可以在 Terminal-Bench 2.1 上超越 Claude Fable 5,同时整体成本低约 11 倍。
面对大模型规模与硬件内存之间高达20倍的算力鸿沟,不重训的“1比特量化”如何把千亿参数的硅基大脑塞进微型设备?
原生 AI TechBio 公司寻明生科( Aureka )完成了 1 亿美元 B 系列融资。距离上一轮 A+ 轮融资,仅仅过去 4 个月。我们在用非常 LLM 的方式在做这个事情。寻明生科创始人兼 CEO 赵伟安博士打了比方,如果传统药物发现是在造油车,我们希望用特斯拉的方式把它重做一遍。
Microsoft 发布了 一个用于在 Azure Kubernetes 服务 上路由智能体流量的参考架构。它将这个问题分解为三个关键选择:由哪个模型响应调用、如何管理调用,以及由哪个 GPU 副本处理调用。
近日,浙江大学 OmniAI 团队在 《Show, Don’t Tell: Evaluating Spatial Cognition in Generative Pixels Rather Than LLM Text》 中提出 ProVisE,让图像生成模型直接在图中回答空间问题,并将视觉答案还原为原 benchmark 可以评分的结构化预测。
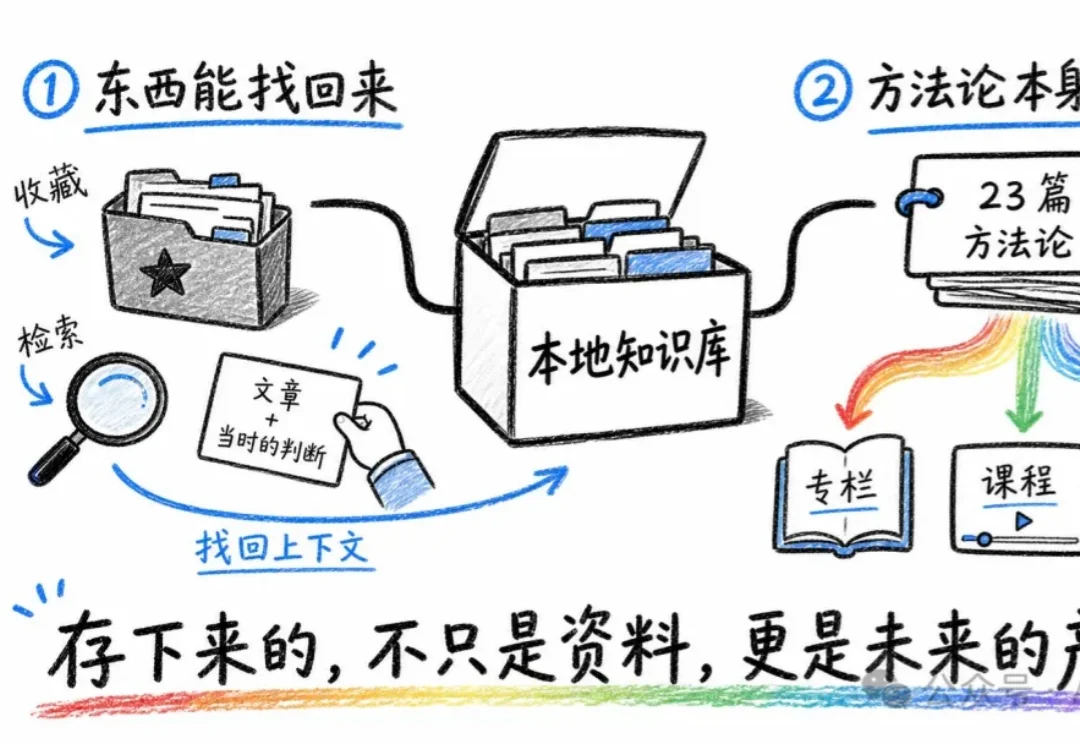
7 月初的时候,我照着 Karpathy 那套 LLM Wiki(简单说就是让 AI 帮你把资料编译成一个能长大的百科)搭了个本地知识库。
近日,米哈游创始人蔡浩宇久违地更新了自己的个人领英,新增了一条独立大模型+智能体开发者(Independent LLM+Agent Developer)的职业经历,时间从2026年7月开始,在新加坡混合办公。